Multidisciplinary engineer, 20+ years experience in industrial R&D, manufacturing, consulting services services for a variety of employers and customers.
Strong analytical skills for problem solving. Facts based management + agile, customer oriented vision of product development. Good team motivator.
C’est une vieille idée que j’avais eue en écrivant “
” puis
: créer un petit jeu tout simple basé sur la transmutation des isotopes.
Ca a l’air compliqué dit comme ça, mais en gros il suffit de cliquer sur un, deux voire trois boutons dans la bonne séquence pour transmuter un élément en un autre. La seule difficulté est qu’il se désintègre tout seul pendant le jeu, en suivant les règles de la physique. Enfin presque, parce que pour
Un bon coup de vibe coding plus tard, c’est fait, vous pouvez jouer à
ou
, où se trouve aussi le
.
J’ai mis “mon” jeu entre guillements parce qu’honnêtement, je n’ai pas codé une seule ligne de ce jeu. Je me suis défini comme concepteur et product owner dans
, et Gemini a fait le reste.
Même le titre ! Quand j’ai dit à Gemini de créer le titre “Isotope” avec des carreaux définissant des éléments chimiques, il a proposé"ISOThOPE" ? parce qu’‘il n’y a bizarrement ni élément “T” ni élément “To” ou “Ot”. Et parce que
…
est aussi l’oeuvre de l’IA, et il me scie littéralement car il agrège plusieurs de mes “prompts” utilisés dans le développement en donnant vraiment l’impression de “comprendre” le jeu. Gemini a été jusqu’à trouver que ma “carte des isotopes” s’appelle un
, ce que j’ignorais.
Les données
L’IA a trouvé “toute seule” une version digitale de cette carte et la façon de l’intégrer dans le jeu sans base de données, et l’explique elle même :
Les données de
ont été extraites à l’aide du script Python
, qui s’appuie sur la bibliothèque Python
, qui intègre une base de données nucléaires issue principalement de :
(évaluations des propriétés nucléaires et de désintégration publiées avec l’
/ IAEA et l’Atomic Mass Data Center).
Les données de l’AME (Atomic Mass Evaluation) et de la CIAAW (Commission on Isotopic Abundances and Atomic Weights).
Les niveaux
J’ai aussi demandé à l’IA de fabriquer des niveaux de jeu de difficulté progressive et elle m’en a pondu une vingtaine, avec
Tutoriel 1 : Capture Électronique : L’atome de Tellure 123 (Te-123) est un cas particulier d’isobare stable. Ajoutez-lui un électron (Clic Droit ou Flèche Bas) pour transmuter un proton en neutron. Vous obtiendrez instantanément de l’Antimoine stable !
Tutoriel 2 : Radioactivité Beta- : L’Oxygène 18 est stable. Ajoutez-lui un neutron (Clic Gauche, Espace ou Flèche Droite) pour le transformer en Oxygène 19. Il deviendra instable et se désintégrera tout seul (Beta-) vers cet élément !
Niveau 3 : Le rêve de l’alchimiste : Transmutation du Mercure 196 en Or stable. C’est la réaction réalisée en 1941 par Sherr, Bainbridge et Anderson en bombardant le mercure avec des neutrons.
(notez la référence scientifique [1] que l’IA a trouvée “toute seule”, mais peut-être dans une de mes réponses Quora…)
etc. jusqu’à
Niveau 23 : L’Alchimie ultime’ : Le sommet de la physique nucléaire : 86 pièges mortels ! À partir du Rhénium 185, utilisez les 3 types de particules (1⚛, 1⚡, 2🔺) dans l’ordre parfait. Neutre d’abord, attendez la cascade Osmium ➔ Tungstène, injectez les deux protons vers l’Osmium 184, laissez la cascade Alpha descendre sur le Tungstène 180, et capturez enfin l’électron pour vous stabiliser en Hafnium 180 !
Jouabilité et difficulté
A vous de me dire dans les commentaires ce que vous en pensez, mais je trouve le jeu sympa, didactique, mais trop facile au début. En fait dans les 13 tableaux initiaux, l’ordre dans lequel on tire les particules n’a que peu d’importance voire pas du tout. Et le moment où on tire des particules non plus, donc on arrive presque chaque fois au résultat quoi qu’on fasse.
La raison est que chaque niveau fait une petite excursion dans la zone “rose” du tableau ou dans la zone “bleue” , donc que la nature produit une chaîne de désintégrations β⁻ ou β⁺ toujours identique, les neutrons ou électrons ajoutés produisant eux-aussi le même décalage quelque soit l’ordre où ils sont absorbés.
J’ai donc demané à l’IA de générer dix tableaux plus complexes en utilisant plusieurs modes de désintégration, notamment $\alpha$ qui rend ça beaucoup plus difficile, mais encore un peu lent. Il va falloir que je tune un peu ….
Le temps logarithmique
Dans la réalité, les demi-vies (T½) des isotopes s’étendent de quelques microsecondes (10⁻⁶ s) à plusieurs milliards d’années (10¹⁷ s). Pour compresser ces 23 ordres de grandeur en quelques secondes de jeu tout en respectant l’ordre de stabilité réel de chaque isotope, j’ai
Les paramètres sont actuellement ajustables au bas de la page du manuel, mais je voudrais fixer des valeurs correspondant à des niveaux de difficulté.
Il y a donc encore un peu de boulot, votre feedback dans les commentaires est bienvenu, voire votre aide dans GitHub aussi…
itch.io
est le site de référence pour les jeux “indépendants”. il en contient des centaines de milliers. Et avec l’IA, ce nombre s’accroît de 6000 par jour !!!
Avec ISOThOPE, ça a fait 6001 hier…
Mon but n’est pas de faire fortune (le jeu est gratuit) mais de voir ce que ça donne de le placer sur un tel site. Dès que le nombre de joueurs dépassera celui des visites sur cette page, ça aura valu le coup.
Traductions
Pour que le jeu soit intéressant pour un large public, il est traduit en anglais, espagnol et chinois, par un
généré par IA, et utilisant l’IA pour la traduction. (ok je vais ajouter l’allemand et l’italien dans la prochaine version…)
Mais en y pensant, je me suis dit que cette page elle-même méritait d’être au moins en anglais… Donc qu’il faudrait que je passe mon site en multilingue… ce que Hugo supporte nativement… Donc voilà c’est fait aussi : drgoulu.com a désormais un certain nombre de pages traduites en anglais grâce à ISOThOPE !
Références
R. Sherr, K. T. Bainbridge et H. H. Anderson, « Transmutation of Mercury by Fast Neutrons », Physics Review, vol. 60, no 7, 1941, p. 473-479 doi:10.1103/PhysRev.60.473
PFC m’a soumis cette vidéo pour le moins étonnante :
Elle provient de l’excellente
de maths du blog de maths
connu
et montre quelque chose de très surprenant :
Si on fait glisser un chariot de masse M=1 vers un autre chariot de masse m=1 immobile qu’il percute dans un choc parfaitement élastique (= sans perte d’énergie) , et que ce chariot rebondit contre un mur parfaitement élastique (deuxième choc), il revient vers le chariot de masse M et le re-percute (troisième choc).
Mais si on augmente la masse du premier chariot à M=2, le petit chariot de masse m=1 va faire deux aller-retours entre le chariot de masse M et le mur : 5 chocs. Avec un cube de masse $M=8$ poussant un cube unité $m=1$ (comme dans l’animation 3D d’ entête générée par le
ci-dessous), on obtient 9 chocs. Et intuitivement, on sent bien qu’en augmentant M, on aura de plus en plus de chocs.
La suite OEIS
donne le nombre de chocs en fonction de M, mais ne va pas assez loin pour voir LE phénomène intéressant découvert par Galperin en 2003 [1]:
avec M=100, on obtient 31 chocs
avec M=10'000 on obtient 314 chocs
avec M=1'000'000 on obtient 3141 chocs
avec M=100'000'000 on obtient 31415 chocs
et sous vos yeux émerveillés vous voyez apparaître une à une les décimales de Pi : pour M=100^n vous obtenez le n-ième terme de
* !!!
Incroyable, non ? Testez vous-même avec la simulation interactive ci-dessous :
Présélections :
t = 0.00V = +1.00, v = 0.00
}
Mais POURQUOI ???
Comme vous j’imagine, je n’ai absolument pas vu de relation entre ce petit problème de mécanique idéalisée et le plus célèbre des nombres transcendants.
C’est l’IA qui me l’a indiquée dans le petite équation de la conservation de l’énergie cinétique $e_c$:
$$ M.V^2 + m.v^2 = 2.e_c $$
qui sent bon l’équation paramétrique d’un cercle ($x^2+y^2 = r^2$)
En posant $x=\sqrt{M}.V$, $y=\sqrt{m}.v$ et $r=\sqrt{2.e_c}$, on s’aperçoit que l’état de notre système défini par les vitesses $(V,v)$ se déplace sur un cercle de la manière suivante :
(source : [2])
À chaque fois que le petit bloc tape le mur, sa vitesse s’inverse (changement de signe), ce qui correspond graphiquement à une réflexion verticale dans notre repère. À chaque fois que les deux blocs se rentrent dedans, le point se déplace sur le cercle d’un angle $\theta$ tel que $\arctan{\theta} = \sqrt{m/M}$
Et le processus se poursuit jusqu’à ce que la vitesse v soit trop petite pour rattraper V, près de l’axe x négatif (point 9 sur le dessin)
le nombre de collisions correspond donc au nombre de fois où on peut répéter l’angle $\theta$ dans $\pi$, qui est comme chacun sait la “bonne”
correspondant à 180° (en fait c’est
mais bon…)
donc on a
$$collisions \approx \theta/\pi$$
Reste le $100^n$ …
Quand $M >> m, \theta$ devient très petit et on peut approximer $tan (\theta) \approx \theta$
C’est cette approximation géométrique ultra-précise qui “force” la physique macroscopique à énumérer textuellement une à une les décimales du nombre $\pi$
Note:
* dans les commentaires de
, on trouve ceci :
À proprement parler, cette propriété, qui équivaut à affirmer que l’intervalle (m*π, π/arctan(1/m)) ne contient aucun entier pour tout m ≠ 10ⁿ, n’est pas avérée. Autrement dit, on ne sait pas avec certitude que A332045 ne contient pas une puissance de 10. Ce point est abordé dans la vidéo de 3Blue1Brown de 2025 intitulée « Why colliding blocks compute pi », qui fait suite à la vidéo de 2019.
Références :
Galperin G. A., Playing pool with π (the number π from a billiard point of view), Regular and Chaotic Dynamics, 2003, Volume 8, Number 4, pp. 375-394 doi:10.1070/RD2003v008n04ABEH000252
Aretxabaleta, X.M.; Gonchenko, M.; Harshman, N.L.; Jackson, S.G.; Olshanii, M.; Astrakharchik, G.E. The Dynamics of Digits: Calculating Pi with Galperin’s Billiards. Mathematics2020, 8, 509. doi:10.3390/math8040509
Notebook Jupyter:
Simulation 3D des collisions (collisions_pi.ipynb)
Simulation 3D du billard de Galperin ($M = 8, m = 1 \Rightarrow 9$ collisions)
Ce notebook simule les chocs parfaitement élastiques entre un cube de masse $M = 8$ (arête $L_M = \sqrt[3]{8} = 2$) et un cube unité de masse $m = 1$ (arête $L_m = 1$) glissant sans frottement vers un mur fixe, et génère l’animation 3D en perspective avec le diagramme dans l’espace des phases $(\sqrt{M}\,V,\, \sqrt{m}\,v)$.
Échantillonnage à pas de temps physique constant et rendu 3D perspective
Pour que les vitesses apparentes soient rigoureusement exactes tout au long de l’animation, la trajectoire est échantillonnée avec un pas de temps physique uniforme dt, tout en calant la trame la plus proche de chaque impact sur la position de contact exacte.
Depuis 1990 environ j’utilise des gestionnaires de références bibliographiques pour retrouver mes lectures et les citer proprement. Pendant ma thèse c’était
sur Mac, puis j’ai
et
pendant mes années Windows, entassant environ 9430 références d’articles, livres scientifiques et brevets, et 4827 fichiers .pdf totalisant 3.4 Gb.
C’est pas beaucoup, mais trop pour le stockage gratuit offert par Mendeley (2 Gb) ou Zotero (300 Mb). Donc j’avais mis mes .pdf sur Google Drive et spécifié le dossier synchronisé sur mon PC comme dossier pour les pièces attachées de Mendeley. J’y avais donc un accès transparent sur mon PC, et possible depuis mon smartphone.
Mais :
j’ai migré sous Linux et Proton Drive : plus de synchro bidirectionnelle (ou pas encore…)
Mendeley avait une app Android utilisable, mais ils l’ont retirée et la version web est inutilisable sur smartphone
Par contre
, un peu minimale mais utilisable
et surtout Zotero permet de stocker les .pdf sur un serveur
alors que Mendeley ne permet que de payer pour un stockage plus gros.
Mais encore, Mendeley appartient à Elsevier alors que Zotero est open source
Et ça, ça change tout.
Parce qu’en 30 ans de collecte d’articles en tous genres migrés de PC en sites et de logiciels en autres logiciels et vice-versa, ma bibliothèque avait quant même pas mal souffert, et
D’abord, j’avais une multitude de références duplifiées, voire triplifiées, et Zotero ne permet que de fusionner des références une par une à la main. Heureusement ChenglongMa a créé
un plugin qui automatise ces fusions. Je l’installe illico mais malheureusement, il ne fusionnait que les références du même type, or j’avais pas mal de duplicates de types différents comme “Rapport” et “Article”.
L’Open Source à l’ère du Vibe Coding, c’est génial : j’ai forké et cloné ce plugin chez moi, et en ne connaissant strictement rien à l’API de Zotero ou à l’écriture de plugins pour ce logiciel, j’ai juste donné un “prompt” du genre:
autorise la fusion de références de types différents, en choisissant le type qui minimise la perte d’information
Quelques minutes plus tard je pushe un
(avec documentation en chinois…) et le même jour
et dorénavant zoplicate est goulument plus puissant.
Mais les doublons n’étaient pas le seul problème de ma bibliographie.
Toujours en pur Vibe Coding, j’ai trois outils regroupés dans un seul projet “zotero-tools” :
qui nettoie les titres, tags, pièces jointes
qui a raccroché tous mes .pdf isolés à des articles, ou les a créés à partir du .pdf
pour-la-science, qui devait importer des articles depuis
, mais j’ai finalement décidé de faire autrement
Pour la Science
En fait 4617 de mes références sont des articles du journal
auquel j’ai été abonné très longtemps avant de
pendant 10 ans. Mais ce journal est vraiment bien, et en espérant que leur service client ce soit amélioré, je me suis réabonné…
Mais le plugin
pour Vivaldi (et Chrome) ne reconnaît hélas pas le site de pour la science pour importer correctement les articles.
Sauf qu’on peut lui apprendre…
Fork de
, clone, vibe coding en mentionnant
à l’IA comme référence,
, et
: une heure plus tard Zotero sait importer les articles de Pour la Science !
La plaie quand on a un “vieux” site, ce sont les liens cassés : pages modifiées, effacées, redirigées n fois, sites complets disparus ou pire, repris par des casinos en ligne …
Sur drgoulu..com, il y avait plus de 3500 liens qui ne mènent plus au bon endroit. Sur mon ancien site Wordpress, j’avais un plugin qui m’informait chaque semaine de nouveaux liens cassés, ce qui me faisait une belle jambe….
Et puis, lors de la
, c’est l’IA qui été chercher “toute seule” des images manquantes sur
, plus particulièrement sur la
, l’incroyable site qui archive les versions passées de beaucoup de pages internet.
Par exemple en cherchant “drgoulu.com” sur
, on peut retrouver:
Et ça m’a donné la lumineuse idée* de l’utiliser pour restaurer les liens cassés !
archive_broken_links.py
Un petit coup de vibe coding plus tard, j’ai un
qui teste tous les liens du site, les corrige s’il y a redirection, et va les chercher à la bonne date s’ils sont cassés.
Un quart d’heure plus tard, ça n’a pas corrigé tous les problèmes, mais beaucoup :
Là encore c’était faisable sans IA, et peut être sous WordPress, mais beaucoup, beaucoup plus compliqué
donotlink.it
La Wayback Machine remplit désormais aussi une autre fonction sur drgoulu : lier les sites que je ne voulais pas référencer.
Pour illustrer certains articles sur les pseudo sciences, je voulais faire des liens mais sans permettre aux sites visés de se prévaloir d’une référence de ma part, qui aurait fait monter leur score sur Google. J’ai donc utilisé le site
qui faisait ça, mais qui a disparu.
Je découvre grâce à la Wayback Machine que son
, mais je n’ai pas l’intention de ressusciter ce site désormais peu utile.
Car la Wayback Machine remplit exactement le même rôle ! Un lien vers une page archivée ne rapporte plus lien à son auteur. : ses bêtises sont archivées pour longtemps sans rien lui rapporter.
Et c’est peut-être la plus grave menace qui pèse sur le fantastique outil qu’est la Wayback Machine : qu’un
…
Note * vous avez remarqué ? Quand l’IA a fait ça j’ai juste dit qu’elle l’avait fait, comme si c’était normal. Alors que quand c’est moi qui l’ai fait, c’était une lumineuse idée…
J’ai réalisé en une heure et fignolé en une deuxième heure un très vieux projet :
Représenter l’
en 3D, avec des bulles par pays à la façon
.
L’idée est de représenter les 4 facteurs des émissions de CO2 de chaque pays sur les 3 axes :
X pour le
(PIB/POP en $ constants / personne)
Y pour l’
du PIB, la quantité d’énergie utilisée pour produire un dollar de biens ou services (E/PIB , en kWh / $)
Z pour l’
, la quantité de CO2 émise pour produire l’énergie (CO2/E, en g CO₂ / kWh)..
et la taille de la bulle pour la population (POP), mais l’app permet de sélectionner plutôt les émissions par habitant (CO2/POP) ou les émissions totales par pays
Le résultat est ci-dessous (et sur
):
(le
, si vous voulez contribuer ou remonter des bugs…)
On y voit plein de choses intéressantes, mais surtout (c’était le but) que les situations des pays sont TRES différentes, et que par conséquent leurs priorités pour limiter, puis réduire leurs émissions sont forcément différentes aussi.
Là où mon IA de codage m’a une fois de plus scotché, c’est qu’elle a ajouté “toute seule” l’échelle de temps. J’avais juste dit “visualise façon Gapminder” en pensant aux bulles par pays, mais cette fonction d’animation montre de façon très claire la
et à la (lente) réduction des émissions. Si si, regardez bien …
Edit du 7 octobre : suite à une discussion avec PFC, j’ai ajouté dans les volumes des sphères sélectionnables les données d’ “émissions basées sur la consommation” selon le
qui publie
Les données
et ici
Comme ces données ne sont pas disponibles pour tous les pays et pas avant 1990, le graphique affiche de petits points aux coordonnées XYZ en cas de données indisponibles
Sur l’ancien drgoulu.com, j’utilisais Google Analytics pour obtenir les statistiques sur l’accès au site. J’aurais pu continuer avec eux, mais
je suis dans un processus de deGAFAMisation
j’étais intrigué depuis quelques temps par ce petit widget
est surtout connu pour ses fonctions de sécurité, mais en investiguant j’ai vu qu’ils proposent des statistiques semblables à celle de Google Analytics, mais aussi bien plus que ça, même avec un compte gratuit,
Ils ont notamment
, un site qui analyse votre site web pour voir si les agents IA peuvent le lire, voire utiliser l’API du site pour faire des choses…
Au début, drgoulu.com était fermé comme une banque suisse :
(j’ai oublié de faire une capture d’écran de l’état initial, mais elle ressemblait à ça)
Peut mieux faire
Je voulais surtout que les IA des moteurs de recherche trouvent mon contenu puisqu’on voit de plus en plus que les recherches par IA remplacent les recherches “simples”.
Pour ça il faut surtout la :
Markdown Negotiation
Les IA parlent
. C’est le format de leurs sorties texte, mais aussi de leurs “prompts” d’entrée et de tous les textes qu’elles peuvent lire facilement. Pas le HTML, trop fantaisiste et peu structuré. Du Markdown ou rien.
Donc pour la plupart des sites, il faut un truc qui convertit le HTML d’une page en Markdown pour IA. Sur Wordpress, il y a des plugins comme
qui font ça, sinon Cloudflare a un outil
qui le fait pour n’importe quel site, mais il faut un compte payant…
Mais après avoir
, mon contenu est déjà en Markdown ! Simplement il n’est pas sur drgoulu.com mais
…
“Il suffit de” dire à Cloudflare d’aller chercher sur GitHub le Markdown correspondant à chaque page HTML sur drgoulu.com. Ca se fait avec un “worker”, un petit bout de code que Cloudflare exécute sur toute requête idoine, et voilà ! C’est gratuit et ça prend moins d’une milliseconde (!!!) par requête:
robots.txt (avec Content-Signal)
je crois que c’est Google qui avait lancé ça il y a longtemps. robots.txt est un petit fichier présent sur tous les sites web qui dit aux moteurs de recherche quoi indexer.
C’est elle qui dit aux IA bien élevées
avec le contenu du site, ou pas.
J’ai un peu hésité sur ai-train qui permet aux IA d’apprendre à partir du contenu du site. Et puis je me suis dit que mon contenu était publié sous licence
, donc que pour autant qu’‘une IA me cite comme source de temps à autres, elle pouvait apprendre des choses aussi bien que vous ;-)
A ce stade c’était déjà pas mal :
API, Auth, MCP & Skill Discovery
A priori je ne voyais pas trop l’intérêt d’aller plus loin en expliquant à des IA qu’elles ne pouvaient rien faire d’autre que lire mon site pour s’instruire, mais tant qu’à faire, j’ai ajouté :
qui dit que drgoulu.com n’a pas d’API
qui dit comment un utilisateur pourrait se connecter au site. (Ce n’est pas le cas)
tout ça est résumé dans
en markdown pour les IA, qui peuvent ainsi éviter de ressembler à des hackers attaquant un site pour comprendre son contenu
. Quoi de mieux qu’
?
,
et
Et là j’ai été scié !
Dans mon petit esprit humain limité, j’ai toujours pensé que drgoulu.com ne servait qu’à communiquer ma prose. Je n’y voyais aucune autre utilité, aucune fonction interactive (à part les commentaires, mais ils sont délégués à disqus.com)
J’ai oublié le moteur de recherche !
La bête petit loupe là-haut de la fenêtre vous permet de rechercher des articles sur drgoulu.com super vite grâce à un index tout cuit. Pourquoi une IA ne l’utiliserait-elle pas plutôt que de tout réindexer chez elle ? Surtout qu’en plus, il y a une astuce technique qui lui permet de récupérer les résultats directement en markdown !
For any article URL on `drgoulu.com`,
request the page with an `Accept: text/markdown` header
to receive the raw markdown content directly:

```http
GET /2026/09/slug/ HTTP/1.1
Host: drgoulu.com
Accept: text/markdown
```
WebMCP et ARD (Agentic Resource Discovery)
est un standard permettant de fournir des outils JavaScript à des IA. Concrètement, le fichier
est ajouté à toutes les pages de drgoulu.com pour donner un accès au moteur de recherche interne du site. Franchement je n’aime pas trop ça, ça alourdit un peu le code des pages et je ne vois pas trop l’intérêt pour l’instant.
Par contre l’ARD est implanté par un simple fichier
qui résume tout ce qui précède sous une autre forme.
J’ai découvert et appris plein de choses, mais mon impression est que c’est encore un peu un fouillis de “standards” qui vont encore évoluer.
Mais
Jamais sans les IA !
Honnêtement, je ne me serais jamais lancé dans cette aventure sans les IA, et notamment celle embarquée dans Cloudflare qui est remarquable. Il y a tellement de trucs à configurer dans les paramètres DNS, dans le .htaccess du site, et tellement de petits bouts de code qui doivent se causer sans (?) trou de sécurité que même un expert sans IA aurait mis plus longtemps que moi avec, j’en suis convaincu.
Il y a notamment eu une récursion infinie lors de la résolution du path de
par le worker qui était bien gratinée, je ne sais pas comment j’aurais pu résoudre ça en moins de trois heures. Là ça a quand même pris 10 minutes à une IA spécialisée pour trouver le bug et le corriger…
ce qui est assez extraordinaire, c’est la capacité des IA actuelles à générer des “prompts” pour d’autres IA. En gros celle de Cloudflare me disait
copiez/collez ça dans l’IA d’infomaniak puis revenez ici cliquer sur le bouton “continue”
puis
copiez/collez ça dans l’IA de votre IDE de développement et revenez pour les tests
etc. Voilà un exemple d’un tel prompt :
Implement Link Response Headers
Add Link response headers to your homepage for agent discovery per
RFC 8288 and
RFC 9727 Section 3.
Requirements
Return `Link` headers on your homepage response pointing to machine-readable resources
Use registered relation types: `api-catalog`, `service-desc`, `service-doc`, `describedby`Example: `Link: ; rel="api-catalog"`Multiple Link headers or comma-separated values are both valid
Cloudflare
Use Transform Rules or
Workers to add Link headers
without modifying your origin server.
Validate
```
POST https://isitagentready.com/api/scan
Content-Type: application/json
{"url": "https://drgoulu.com"}
```Check that `checks.discoverability.linkHeaders.status` is `"pass"`.
Finalement, le résultat est là : drgoulu.com est
100% Level 5 Agent-Native
Et voilà le résultat de tout ceci dans
:
drgoulu.com est prêt pour la
comme me l’a confirmé l’IA :
drgoulu.com valide désormais l’ensemble de la chaîne Auth.md + OAuth / OIDC Discovery + Protected Resource Metadata au plus haut niveau de conformité agent (Level 5 Agent-Native) !
Lors d’un très agréable weekend avec d’éminents anciens collègues de l’Institut d’Automatique (IA…), une discussion a porté sur l’utilisation de l’intelligence artificielle (IA aussi…) en mathématiques, puis sur le niveau d’abstraction que cette application permet.
J’ai alors mentionné ma petite exploration d’il y a dix ans (déjà) relatée dans :
Ni moi ni aucun collègue ne comprenait ce que pouvait être la “tour chromatique de théories” découverte lors de ce premier article, alors j’ai pensé demander à l’IA de vulgariser ceci:
Explique la k-théorie de Morava à un ingénieur
voici le début et la fin de son excellente réponse:
La K-théorie de Morava est un outil de pointe en topologie algébrique (plus précisément en théorie de l’homotopie stable). Pour un ingénieur, la meilleure façon de l’aborder est de la voir comme un analyseur de spectre mathématique ultra-puissant conçu pour décomposer des espaces géométriques complexes en fréquences fondamentales, appelées “hauteurs chromatiques”.
La K-théorie de Morava est l’outil ultime de spectroscopie algébrique. Elle permet de découper l’information topologique complexe d’un espace en couches indépendantes (K(n)), facilitant le calcul d’invariants géométriques qui seraient autrement impossibles à extraire du signal d’origine.
Tous les ingénieurs et la mathématicienne étaient scotchés par cette merveilleuse impression de réaliser qu’un vaste monde s’ouvrait derrière la
que vous avons utilisée à gogo pendant nos carrières.
Là, Hacer, analyste financière, a demandé “et pour un enfant de cinq ans” ?
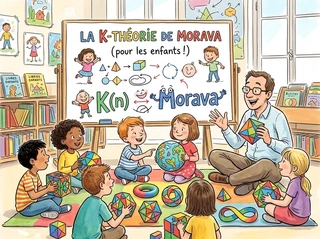
J’ai lancé un second “prompt”, et alors que je pensais que l’IA répondrait “désolé c’est trop compliqué pour un enfant de cinq ans”, nous avons reçu cette réponse absolument fantastique :
(image générée par Gemini IA)
Explique la k theorie de Morava à un enfant de 5 ans
Imagine que tu as un immense sac rempli de formes géométriques magiques et de jouets bizarres. Certains sont simples comme des ballons, d’autres sont tout emmêlés comme des nœuds de ficelle. Tu aimerais bien les ranger et comprendre comment ils sont faits, mais c’est trop difficile parce qu’ils changent tout le temps de forme !
La K-théorie de Morava, c’est comme une collection de lunettes magiques de super-héros pour regarder ces jouets.
Chaque paire de lunettes a une couleur différente, et chaque couleur te montre un secret caché :
👓 Les lunettes n°0 (rouges) : Elles te montrent juste la taille du jouet. Est-ce qu’il est gros ? Est-ce qu’il a un gros trou au milieu comme un donut ? C’est le niveau le plus facile.
👓 Les lunettes n°1 (oranges) : Elles deviennent plus précises. Elles te montrent si le jouet peut s’enrouler sur lui-même comme un toboggan en colimaçon ou un élastique.
👓 Les lunettes n°2, 3, 4… : Plus le numéro de la lunette est grand, plus la lunette est puissante ! Elles te permettent de voir des détails minuscules et des secrets magiques cachés tout au fond du jouet, que personne d’autre ne peut voir.
Si tu regardes ton jouet avec toutes les lunettes l’une après l’autre, tu finis par connaître absolument tous ses secrets, et tu sais exactement comment il est fabriqué !
En gros, c’est une boîte à outils magique pour aider les grands mathématiciens à comprendre les formes les plus compliquées de l’univers.
Dis-moi si tu veux :
Qu’on utilise une autre image, comme des tiroirs de rangement magiques ou des tamis pour chercher de l’or ?
Que je t’explique l’histoire du donuts et de la tasse de café (une blague préférée des mathématiciens) ?
C’est évidemment extraordinairement simplifié mais rend l’idée fondamentale de la théorie compréhensible pour tout-le monde.
A ce niveau, le fameux résultat gravé sur la tombe d’Urs Würgler dit comment fabriquer les n-ièmes lunettes à partir des lunettes précédentes.
La discussion s’est poursuivie sur le thème de la vulgarisation : Pour un vulgarisateur vaut-il mieux bien connaître le sujet ou bien connaître le public cible ? L’IA nous donne la seule réponse désormais possible : les deux !
Pendant les années 2019-2026, j’ai délaissé ce blog, mais j’ai été extrêmement
.
Initialement, je cherchais une solution plus adaptée à
, le site du C@fé des sciences dédié aux enfants. WordPress étant peu adapté à gérer les Questions/Réponses, j’étais tombé sur Quora alors en plein lancement, mais ils n’étaient pas intéressés (“quoi ? un site où des adultes répondent à des enfants, mais vous êtes inconscients…” m’avaient répondu les amerloques…)
de DrGoulu à Quora…
Mais à la réflexion ils n’avaient pas tort, et en me prenant peu à peu au jeu, je me suis rendu compte que mes articles de blogs visaient parfois un public trop restreint, et qu’il était peut-être plus constructif de répondre aux questions d’autrui plutôt qu’aux miennes.
Mes quelques 15'000 réponses sur Quora depuis 2019 sont vues environ 50'000 fois par semaine et drainent un trafic non négligeable vers drgoulu.com, mais Quora me semble être devenu un “réseau social comme les autres”.
Initialement, on devait utiliser son nom réel et des humains remarquables (Silhem puis Amaury) s’occupaient de la modération avec des critères stricts qui garantissait une grande qualité du contenu.
Puis le “business model” de Quora est devenu plus clair : drainer le trafic des questions posées à Google vers Quora. En acceptant absolument n’importe quelle question stupide, et sans réel intérêt pour la qualité des réponses
… et retour
Ma décision de relancer le blog drgoulu.com est très lié à un raz-le-bol de Quora, mais alors, outre la
, il me fallait logiquement aussi migrer mon contenu Quora sur le nouveau site drgoulu.com
Heureusement, les auteurs de réponses sur Quora restent propriétaires de leur contenu et peuvent l’obtenir sur simple demande.
J’ai donc obtenu sur simple demande 23 fichiers .zip totalisant 222 Mb, chacun contenant un unique fichier .html avec un millier de mes contributions et un dossier avec les images correspondantes.
(Quora-importer…)
A ce moment là, je pensais encore conserver drgoulu.com sous WordPress et j’ai commencé par créer (en pur vibe coding) une extension d’importation (en PHP) de Quora sous WordPress :
.
Elle marche relativement bien, ajoutant directement les articles et les images dans la base de données de WordPress, mais j’ai buté sur un problème :
Les sujets de chaque article ne sont pas inclus dans les fichier .html (inclus dans les .zip si vous avez suivi…) donc il faut les chercher sur la page Quora correspondant à chaque réponse.
Sauf que l’URL de cette page n’est pas non plus dans le fichier .html …
Donc l’importateur doit retrouver cet url à partir du titre de la réponse et du nom de l’auteur.
Sauf que Quora limite la longueur de ce titre, et convertit certains caractères spéciaux en tirets, et pas d’autres, et que cette conversion a changé au cours du temps…
Donc cette recherche en nécessite parfois plusieurs, est assez compliquée, et qu’un hébergeur n’aime pas trop qu’un site aille très souvent en visiter un autre. En fait WordPress a carrément refusé d’accepter mon extension dans la liste officielle…
(… et Quora2Wordpress)
J’ai donc “vibe codé”
, un autre outil, en Python, qui réalise la conversion des .zip en fichiers .xml au format WXR de WordPress, prêts à être importés.
C’est là que j’ai réalisé que la mise au point de cet outil était très fastidieuse, car il fallait plusieurs opérations pour finalement visualiser les articles Quora convertis, voir ce qui n’était pas correct, et tout recommencer.
Quora2Hugo
Alors qu’avec un site statique comme Hugo, je pouvais voir le résultat immédiatement, et éventuellement faire des corrections directement sur les fichiers markdown déjà convertis au lieu de devoir tout recommencer.
C’est une des raisons qui a fini de me décider à abandonner WordPress pour un générateur de site statique, Hugo en l’occurrence.
Une fois cette décision prise, j’ai simplement demandé à mon IA préférée de réaliser
sur la base de quora2wordpress en générant des fichiers markdown contenant chaque article, avec les images placées au bon endroit, des shortcodes hugo pour les images, les liens, les références bibliographiques, etc.
De plus je ne voulais pas noyer drgoulu.com sous 15'000 articles Quora dont beaucoup sont des réponses lapidaires, donc j’ai défini que toutes les réponses de moins de 500 caractères devaient être considérées comme des brouillons que je publierai le cas échéant.
Quelques jours de mise au point plus tard, le nouveau drgoulu.com sous Hugo contient:
les 695 “anciens” articles de drgoulu.com sous Wordpress
Le premier article “scientifique” du nouveau DrGoulu.com est dédié à un documentaire palpitant sur le groupe de citoyens qui a péniblement révélé les fraudes commises par
et son équipe en promouvant l’
pendant la pandémie de Covid-19.
Ce documentaire en 4 épisodes est actuellement visible sur HBO, mais nul doute qu’il sera prochainement sur les chaînes publiques car il est produit par
. Une chose est sûre, si vous vous intéressez au fonctionnement de la science, bonne ou mauvaise, ne la manquez pas.
Je “spoile” un peu plus bas, mais plutôt pour “teaser”, à vous de voir…
le documentaire montre notamment deux travers réels de la recherche scientifique:
la course aux publications. Comme mentionné au dernier épisode, Raoult a cosigné plus de 3500 articles (!!!) pendant sa carrière, soit 3 par semaine (!!!), ce qui a rapporté 10 millions d’euro de subventions à son unité de recherche par simple arithmétique, sans évaluation de la qualité de cette déferlante de papiers
l’infaillibilité pontificale de beaucoup de grands pontes qui avancent en âge et en ego. Comme Montagnier avec sa mémoire de l’eau ou dans une certaines mesure JPP en cosmologie, certains oublient l’humilité et la prudence nécessaires dans leur métier et sont tentés d’abuser de leur notoriété en faisant le forcing pour un Prix Nobel ou une place de dans l’Histoire.
Il montre aussi que dans ces cas, ce ne sont pas les pairs ou les politiques qui tirent la sonnette d’alarme. Ils sont trop impliqués, ou pas vraiment concernés.
Raoult, son acolyte chargé de harceler ses détracteurs sur les réseaux sociaux, le ministre de la santé de l’époque et d’autres ont tous fait la même erreur : croire (ou dire…) qu’il fallait être un infectiologue de renom pour voir que les papiers de Raoult ne valaient pas tripette.
En fait il suffit de connaître le fonctionnement de base de la recherche scientifique (qu’on apprend lors d’un doctorat) d’avoir des notions de base de maths et de statistiques (niveau collège…) et un esprit critique pour détecter des anomalies dans un article scientifique.
Et avec les moyens de communication d’aujourd’hui, quelques personnes partageant les mêmes préoccupations peuvent facilement créer un “gang”. En l’occurrence ce sont :
Guillaume Limousin professeur de mathématiques (et ancien chercheur)
Alexander Samuel : Enseignant, titulaire d’un doctorat en sciences et chanteur de metal.
Fabrice Frank : Chef d’entreprise dans l’informatique et passionné de surf.
Samuel : Chercheur titulaire d’un doctorat en sciences (son nom de famille n’est pas rendu public dans le documentaire).
Frédérique Delestaing : Infirmière exerçant à Marseille
Magali Carcopino-Tusoli : Médecin spécialiste en médecine interne à Marseille
et cette équipe d’anonymes devenus
de la science s’est baptisée “les trottinettes cerises” en référence:
au titre d’une video de Raoult qui prédisait “Coronavirus : moins de morts que par accidents de trottinette”
au “
”, la tendance hélas naturelle a choisir les données qui soutiennent une hypothèse en écartant celles qui l’infirment
Le documentaire montre très bien que la force de ce groupe vient de leur complémentarité et de leur cohésion face à l’adversaire, voire aux ennemis.
Car ce qui m’a le plus estomaqué, c’est l’incroyable agressivité des “pro Raoult” qui ont harcelé les critiques sur les réseaux sociaux jusqu’à pousser au suicide, les ont menacé de mort, et même agressés physiquement.
C’est un phénomène déjà vu avec les
, de
ou de JPP : des hordes de gens qui n’ont aucune compétence scientifique se mettent à transformer un scientifique en gourou intouchable, quasi religieusement.
Dans le cas de Raoult, le contexte du Covid-19 a certainement conduit de nombreuses personnes à voir en lui un sauveur providentiel, d’autant qu’auréolé de sa réputation, il prévoyait que tout rentrerait dans l’ordre en été 2020, sans deuxième vague ni vaccins…
Contredire Raoult, c’était nier l’existence d’un traitement simple et bon marché, soutenir le confinement et les vaccins de Big Pharma, et ça a rendu beaucoup d’ignorants cons et méchants en plus…
La meilleure nouvelle du documentaire, c’est qu’un “pro Raoult” a fini par être convaincu par les arguments du gang et les a rejoints. Donc c’est possible…
Un des petits reproches que je ferais au documentaire est de ne pas décrire les grosses failles “niveau collège” qui ont rapidement été détectées dans les publications (à part le très faible nombre de sujets de la première étude). Apparemment des juges les ont comprises [1], donc on aurait pu les comprendre aussi…
Un autre petit reproche est de ne pas avoir mentionné
, une chercheuse qui s’est spécialisée dans la détection de fraude scientifique notamment par les images truquées. Elle aussi a détecté des anomalies, a été attaquée en justice par Raoult, et a reçu tellement de soutien qu’il a abandonné les poursuites.
En fin de compte, l’obstination de Raoult l’a éjecté du panthéon de la science française . De “grand scientifique” encensé par le Président Macron, il est tombé dans la poubelle de la science et de l’histoire
Après plusieurs années de quasi abandon, j’ai décidé de faire revivre ce site pour plusieurs raisons :
il tombait en loques et c’était dommage
je veux y transférer une bonne partie de l’énorme contenu que j’ai publié
ces dernières années.
j’ai du temps à perdre, et des IA pour m’aider. Les deux se sont révélés indispensables.
Les problèmes de WordPress
Depuis 2010 ce blog était propulsé par WordPress, qui est devenu un monstre, notamment à cause de la foison de plugins que j’utilisais. Il devenait de plus en plus difficile de gérer les versions, les conflits entre plugins, les mises à jour, et les failles de sécurité, sans compter les bugs de certains, qui ont notamment causé la perte de nombreuses images.
Pourtant, devant l’ampleur de la tâche, j’étais assez réticent à changer de solution. J’ai commencé par copier le site en local sous
, ce qui me permettait de farfouiller dans les fichiers sans passer par FTP, et surtout de ne pas abîmer le site en production. J’ai ainsi pu remettre à jour certains plugins indispensables, notamment
qui a été accepté comme
(même si la bannière dit qu’il est obsolète…)
pour gérer les milliers de liens vers Wikipédia de drgoulu.com
qui était abandonné
et le thème
qui à l’air de l’être car mes “Pull Requests” qui le rendent compatible avec les dernières versions de WP sont ignorées…
Mais même avec tout ça, j’étais encore insatisfait, et attiré par la curiosité : comment faire un blog moderne en 2026 ?
Les sites “statiques”
La tendance actuelle, est clairement aux
: le site est considéré comme un projet informatique qui est “compilé” en pages HTML fixes, “comme dans le temps”. Plus de base de données, plus de PHP, plus de failles de sécurité potentielles, et en plus la navigation devient hyper rapide, comme vous vous en apercevez en parcourant ce site…
Le choix : Hugo
Je suis assez rapidement tombé sur
, mais par acquit de conscience j’ai aussi essayé
qui m’a bien tenté pour son orientation scientifique basée sur Python, Jupyter, etc. mais il est surtout utilisé dans le monde académique, et moins pour les blogs généralistes comme le mien.
J’ai aussi examiné
, dont la technologie a l’air plus moderne encore, peut-être trop…
Après avoir demandé un
, j’ai choisi Hugo dans sa mouture
, à la fois complète et facile à démarrer.
Les outils : Git(Hub), VSCode, …
Pour créer un site, on tape dans un shell :
# Requires Node.jsnpm install -g hugoblox
hugoblox create site
et on remplit les champs, et on obtient un dossier de projet avec tout ce qu’il faut dedans.
C’est tout.
Il n’y a plus qu’à écrire des articles en
, un format de texte enrichi autrefois réservé à de simples fichiers readme.md qui devient très à la mode avec les IA.
A ce moment, il devient très naturel de gérer toutes les modifications apportées au site dans un dépôt git pour être sur de
.
Un site peut d’ailleurs être très facilement être
à chaque push sur GitHub, mais dans le cas de drgoulu.com , je voulais le conserver chez mon hébergeur (infomaniak). J’ai donc configuré une “action” GitHub qui builde le site et synchronise le dossier /public généré avec infomaniak par
ssh. Ca prend environ 6 minutes, ce qui est lent mais acceptable quand on publie un article…
Markdown
Markdown est l’inconvénient majeur des générateurs de sites statiques , et probablement ce qui limite encore Hugo et ses copains par rapport à WordPress : il n’est pas
. Même si
rend le texte plus visuel que du HTML, on ne voit pas le résultat final.
L’approche standard est d’utiliser des plugins de VSCode qui lancent un serveur local et affichent des prévisualisations de la page qu’on édite à chaque “save” de celle-ci
, qui est tout neuf et pas très convaincant pour l’instant
plus abouti actuellement me semble t’il, mais pas encore top.
Sinon, il existe bien des choses comme
, un éditeur et gestionnaire de site Hugo en ligne via GitHub, que j’utilise pour écrire ces lignes parce qu’il est gratuit pendant 20 jours, mais assez cher ensuite, ce qui fait que je ne vais pas le garder, hélas. De plus il fait un rendu un peu intermédiaire, certaines choses étant wysiwyg et d’autres pas.
Les Shortcodes
La difficulté tient aux “shortcodes” qui permettent d’étendre Markdown pour afficher du code formaté, des videos YouTube etc.
Hugo en
permet d’en définir très facilement en
. Je l’ai fait notamment pour:
, un simple portage du
pour WordPress que je m’étais fatigué à maintenir tellement il m’était indispensable, utilisé dans une multitude d’articles pour afficher des références et des couvertures de livres
, un portage de
qui décore les références d’articles scientifiques
Mais avec ça, impossible d’obtenir un rendu “wysiwyg” sans passer par une compilation Hugo…
Sveltia
C’est en cherchant une solution à ceci que je suis tombé sur
. Comme l’indique son nom, l’ambition de ce projet open source est de réaliser un “content management system” complet, mais l’éditeur de markdown me semblait proche de ce dont j’avais besoin.
Le petit wrapper
permet d’intégrer Sveltia comme un module Hugo, et de faire l’interface, notamment en ajoutant un bouton “edit” aux articles, visible uniquement si on est authentifié avec droit d’écriture sur le projet GitHub. (donc moi uniquement…)
Après quelques échanges avec l’auteur principal de sveltia-cms, j’ai constaté que nous objectifs étaient assez différents, donc je me suis résolu à maintenir
que j’ai complété notamment avec :
Le support des shortcodes utilisés sur drgoulu.com
La gestion de la structure des dossiers d’articles, organisés par année
L’intégration du moteur de recherche interne dans la boite de création des liens
et surtout, la …
Prévisualisation en (quasi) temps réel
Il faut l’admettre, la possibilité d’éditer des articles sur le site lui-même est un peu contradictoire avec la notion de “site statique”, car il faut alors un serveur plus sophistiqué qu’un simple serveur web de pages statiques.
Le cycle de compilation normal du site suite à un commit+push de nouveau contenu sur GitHub mentionné plus haut est beaucoup trop lent, puisqu’il prend environ 6 minutes.
Il faut donc un serveur spécifique, en l’occurrence on utilise le serveur de développement de hugo qui permet une compilation simplifiée en 5 à 6 secondes seulement.
J’envisage installer ceci sur Infomaniak un de ces jours, mais pour l’instant je ne l’utilise que pour la rédaction des articles en local.
LA MIGRATION
L’exportation du contenu de l’ancien drgoulu.com s’est passée sans difficulté grâce à
.
Les problèmes sont apparus après car mon vieux site était quand même bien abîmé .
IA = Indispensable Assistant
Franchement, sans l’IA (Gemini) intégrée dans Antigravity (l’IDE que j’utilise de préférence à VSCode), j’aurais abandonné.
Elle a permis de faire des dizaines de recherches/remplacements qui m’auraient pris de heures à la main ou à écrire les regex en quelques minutes.
Le plus incroyable s’est produit lorsque je lui ai demandé de retrouver des images qui avaient disparu car je les avais “hotlinké” sans m’en rendre compte, et que le site d’origine avait bien entendu changé ou disparu. L’IA a pensé “toute seule” à les chercher sur l’
qui conserve les anciennes versions de pratiquement tout internet ! Et les a toutes retrouvées, téléchargées dans le site Hugo, et insérées proprement dans les articles. Wow. En quelques minutes !
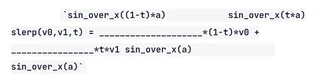
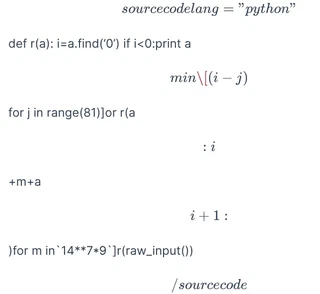
dans
.md, transforme en latex les deux équations sur la fonction slerp qui sont écrites en texte, en t’appuyant sur la wayback machine
(mauvais exemple car le code est sur une seule ligne…)
Commentaires Disqus
Un aspect de drgoulu.com auquel je tiens a aussi été rendu difficile par le passage é Hugo : les commentaires.
J’ai du revenir à
. J’avais utilisé cette solution commericale pendant un temps, puis abandonnée pour revenir aux commentaires natifs de WordPress.
Je n’ai pas beaucoup hésité : il n’y a pas vraiment d’alternative et une bonne partie des commentaires y étaient déjà, donc j’ai installé, et un peu ramé…
Il y a notamment eu un problème un peu technique que j’ai remonté au support Disqus, il est documenté dans un commentaire ci-dessous, que je supprimerai quand il sera résolu.
Et je cherche toujours quelques années de commentaires WordPress qui n’ont pas migré sous Disqus pour une raison inconnue …
(Edit du 8.10 : trouvé ! Le fichier .xml exporté je venait pas de drgoulu.com mais de drgoulu.local, ma copie locale de développement. Or Disqus raccroche les commentaires aux URL exactes des articles… Un petit search/replace dans le xml plus tard, tout est rentré dans l’ordre)
Le gros morceau qui reste, c’est mon projet de
Références:
, article de blog duquel j’ai copié l’image d’entête